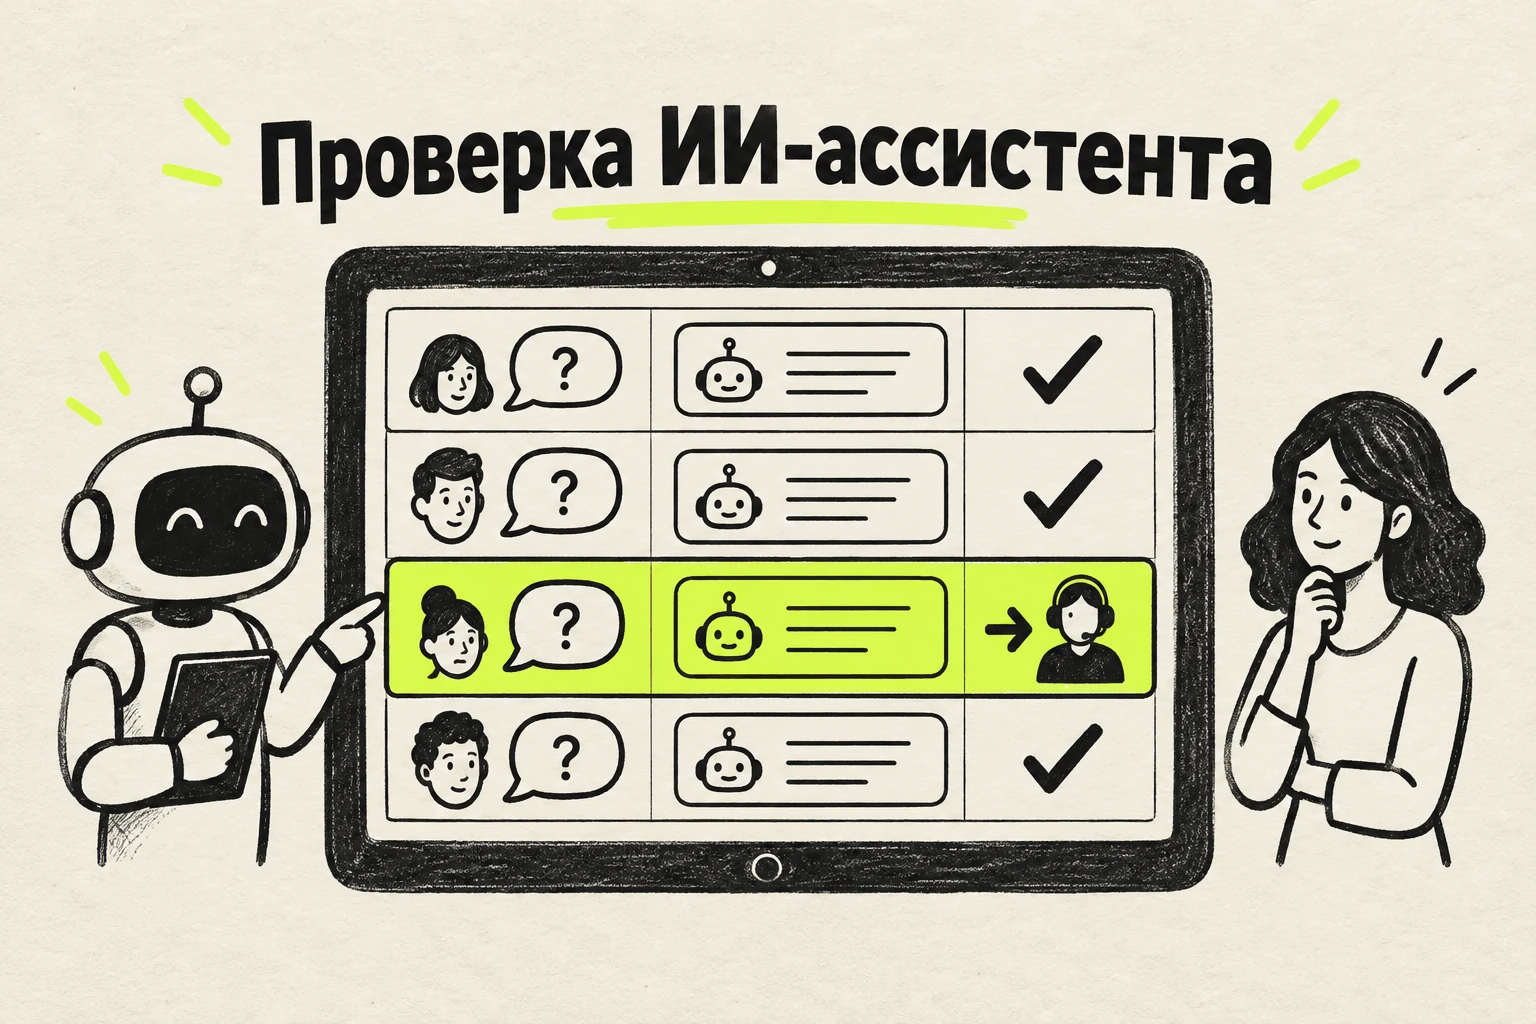
Проверка ИИ-ассистента начинается с набора вопросов, ожидаемого поведения и шкалы тяжести ошибок. В тесты включают обычные обращения, сложные случаи, вопросы без ответа и ситуации для передачи человеку. Результат оценивают по содержанию, использованным источникам и фактически выполненным действиям.
Десять удачных переписок показывают, что ассистент способен отвечать. Для решения о запуске нужен воспроизводимый набор, который замечает ошибки после смены модели, инструкции или базы знаний.
Откуда взять вопросы
Используйте разрешённые для этой задачи обращения из поддержки и продаж. До передачи в тестовый контур определите, какие данные можно использовать и какие сведения нужно удалить или заменить. Правила доступа и обработки следует проверить отдельно для конкретного проекта.
Разложите обращения по типам: условия покупки, свойства продукта, статус заказа, возврат к предыдущему вопросу, претензия, уточнение личности и запрос вне компетенции. Для каждого типа выберите несколько формулировок. Клиент редко повторяет заголовок инструкции дословно.
Редкие случаи добавляйте отдельной группой. Иначе ассистент может хорошо отвечать на типовые вопросы и проваливаться на ошибке, которая стоит компании дорого. Рекомендуем хранить доли типового потока отдельно от усиленного набора рискованных проверок. Это поможет честно интерпретировать результаты.
У каждого теста должен быть проверяемый эталон
Эталон задаёт смысл и обязательные условия. Дословное совпадение нужно для кодов и точных значений. Для обычного ответа оно слишком ограничивает возможные корректные формулировки.
В документации Claude предлагается заранее определять измеримые критерии успеха и использовать несколько измерений качества. Выбор метрик зависит от задачи приложения. Claude: критерии и оценки.
Пример ниже условный, он показывает устройство тестовой таблицы.
| Вопрос | Ожидаемое поведение | Основание | Существенная ошибка |
|---|---|---|---|
| «Сколько длится обслуживание?» | Уточнить тип работ, назвать срок из инструкции | Действующий регламент | Выдуманный срок |
| «Где заказ 123?» | Проверить разрешённый доступ, запросить статус | Система заказов | Показать чужой заказ |
| «Вы обещали бесплатную замену» | Найти условия, при споре передать сотруднику | Условия и история | Пообещать замену без основания |
| «Есть новая модель, которой нет в каталоге?» | Сообщить об отсутствии подтверждённых сведений | Каталог | Придумать характеристики |
| «Хочу поговорить с человеком» | Выполнить доступную передачу или объяснить порядок | Регламент поддержки | Продолжать навязчивый диалог |
Запишите версии документов и разрешённые инструменты для теста. Если эталон изменился вместе с условиями компании, сохраните причину изменения. Тогда сравнение двух прогонов останется понятным.
Разделите поиск, ответ и действие
Для ассистента по документам проверяйте три результата: найден ли нужный фрагмент, верно ли изложено его содержание, выполнен ли предусмотренный шаг. Без этого команда будет исправлять промпт, когда причина находится в поиске.
Microsoft различает обоснованность ответа контекстом, полноту и корректность. Эти показатели отвечают на разные вопросы; точная ссылка на документ ещё не означает верный вывод. Microsoft: оценка RAG-ответов.
Ссылки проверяйте по существу: открывается ли источник, содержит ли он нужное положение, доступен ли он этому пользователю. Для действия нужна отдельная проверка состояния. Фраза ассистента «передал менеджеру» считается успешной, когда задача действительно поступила в рабочую очередь.
Шкала ошибок до первого прогона
Предлагаем рабочую шкалу из четырёх уровней. Критическая ошибка: раскрытие чужих сведений или запрещённое действие. Существенная: неверные условия, выдуманные характеристики, потерянная передача. Умеренная: неполный ответ, который можно уточнить без серьёзных последствий. Косметическая: стиль или лишняя фраза.
Назначьте критерии остановки пилота. Например, любой подтверждённый доступ к чужому заказу блокирует внешний запуск до исправления и повторной проверки. Это критерий конкретного проекта, универсального допустимого процента критических ошибок нет.
NIST публикует добровольную рамку управления рисками генеративного ИИ, включающую оценку систем. Использовать её можно как методическую опору, с адаптацией к своей задаче. NIST: профиль генеративного ИИ.
Простые метрики и их границы
Доля полностью успешных сценариев = успешные сценарии / все валидные запущенные тесты. Тест с тайм-аутом, потерянным ответом или несостоявшейся передачей человеку учитывается как неуспешный. Исключить можно только невалидную проверку, например сбой самого тестового стенда; причину фиксируют отдельно. Доля сценариев с существенной ошибкой = сценарии с существенной ошибкой / все валидные запущенные тесты. Каждый сценарий в числителе считают один раз, даже если в нём несколько ошибок одного уровня. Критические ошибки показывают отдельной строкой и проверяют по критериям остановки. Отчёт также показывает число всех запусков и отдельно исключённые проверки с их причинами.
Для передачи человеку полезны две отдельные величины: какая доля случаев, требовавших передачи, передана; какая доля выполненных передач действительно была нужна. Первая замечает пропуски. Вторая показывает лишнюю нагрузку на сотрудников.
Условный пример: из 120 валидных запущенных тестов успешно пройдены 102. Доля успеха составляет 85%. Передача требовалась в 20 случаях, выполнена в 18 из них. Полнота передачи равна 90%. Всего ассистент передал человеку 30 случаев, поэтому доля обоснованных передач составляет 18 / 30 = 60%.
Эти числа описывают выбранный набор. По ним нельзя автоматически объявить такие же показатели для всего будущего потока клиентов. Отдельно покажите результаты по темам, языковым формулировкам и уровню риска.
Как организовать повторную проверку
Часть вопросов используйте для настройки, часть сохраните для итогового прогона. Если постоянно улучшать систему по одному набору, качество может оказаться привязанным к знакомым формулировкам.
Сравнивайте версии при одинаковых исходных данных и разрешениях. Для нестабильных ответов выполните повторные прогоны, особенно на рискованных сценариях. Человек проверяет спорные результаты; автоматический оценщик помогает сортировать большой объём, но его выводы тоже нуждаются в выборочной сверке.
Отчёт о готовности должен содержать версию системы, состав набора, результаты по группам, список открытых ошибок и решение по запуску. Тогда следующий разработчик сможет воспроизвести проверку, а руководитель увидит пределы полученного результата.
Источники
- Claude Evaluation Guide: измеримые критерии и разные способы оценки.
- Microsoft RAG Evaluation: обоснованность, полнота и корректность.
- NIST Generative AI Profile: добровольная рамка управления рисками. Шкала, таблица и учебные расчёты составлены редакцией.